Desigualdade no Acesso e na Matrícula no Ensino Superior (Índice de Wagstaff)
Visão Geral
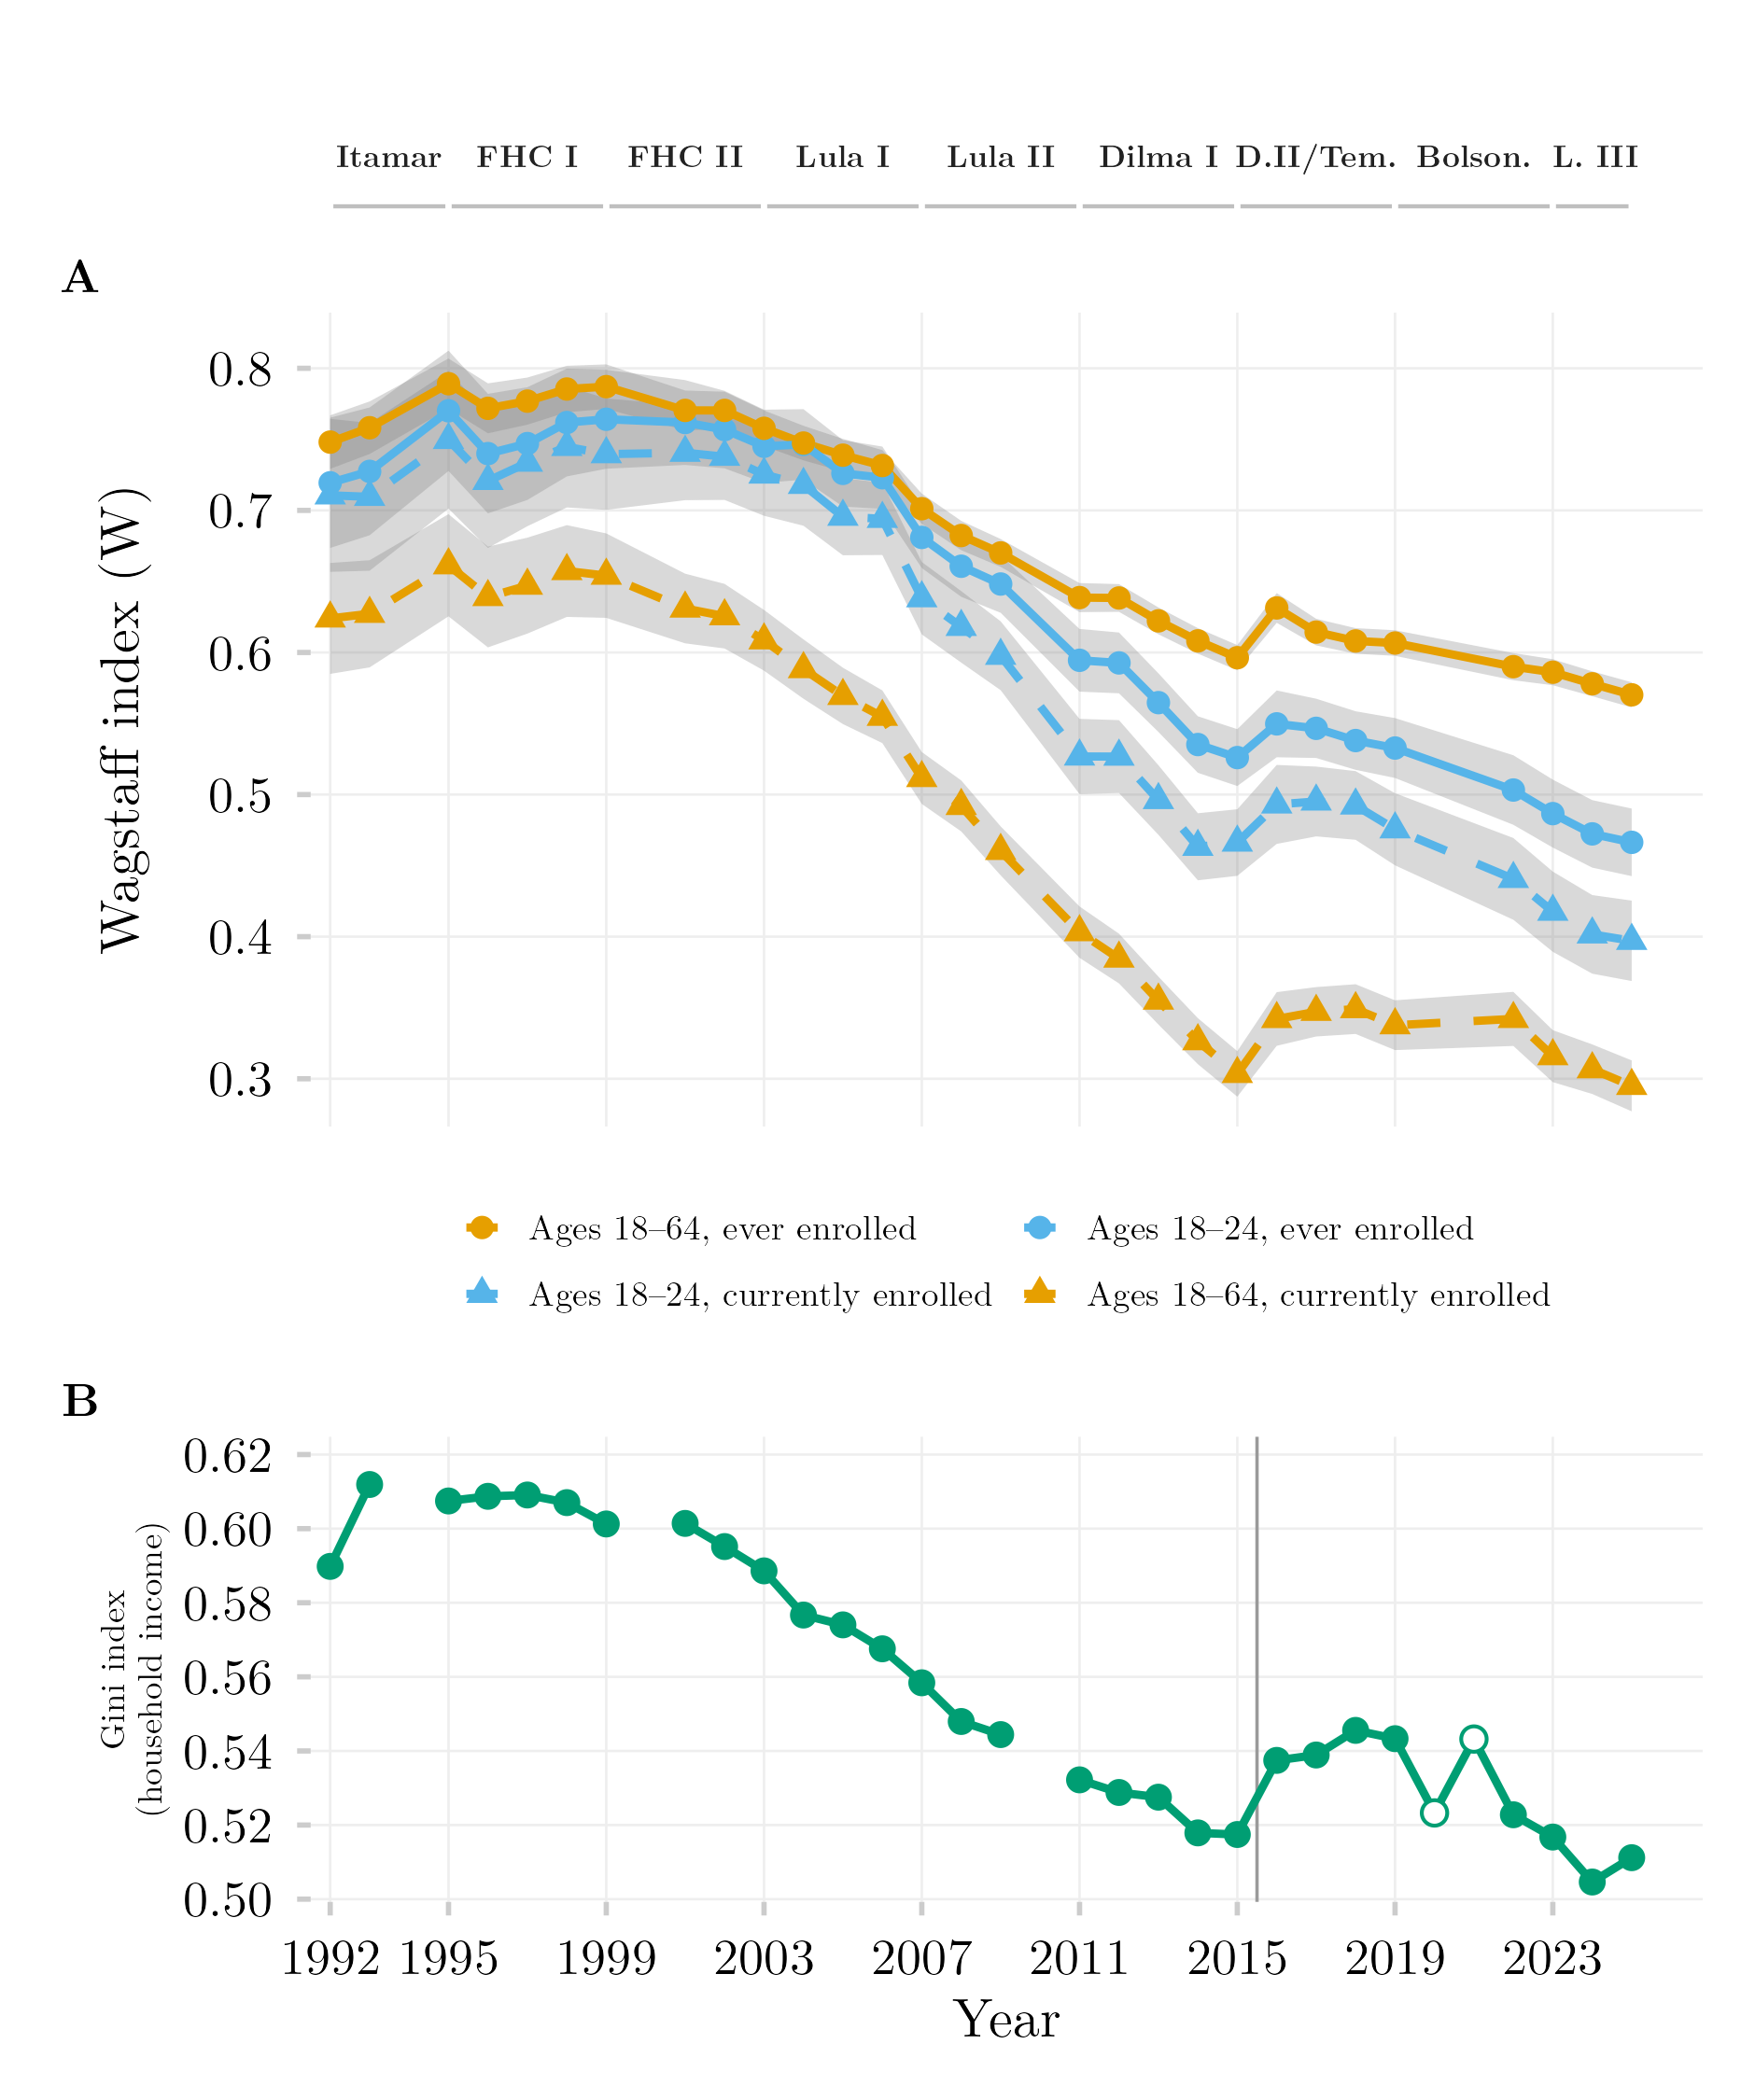
Esta figura mostra o quão fortemente o acesso e a matrícula no ensino superior estiveram atrelados à renda domiciliar no Brasil, e como essa relação evoluiu ao longo do tempo. Ela compara dois resultados — já ter acessado o ensino superior e estar atualmente matriculado — com um painel complementar mostrando o índice de Gini da renda geral como referência. Um valor próximo de zero no índice de concentração significa que o acesso está distribuído de forma equilibrada entre os níveis de renda (independente da capacidade de pagar); um valor alto significa que o acesso continua concentrado entre os mais ricos.
Metodologia
Painel A. O índice de concentração de Wagstaff (W) é um escalar do tipo Gini, delimitado para resultados binários: W próximo de zero indica que o acesso se tornou descomodificado — independente da renda domiciliar —, enquanto um W alto e positivo indica que o acesso continua sendo uma mercadoria, alocada principalmente pela capacidade de pagar. W é calculado via regressão GLM ponderada de survey, sob uma aproximação uniforme de efeito de delineamento de Kish (DEFF = 2,0) tanto na PNAD Anual quanto na PNAD Contínua, para preservar a comparabilidade longitudinal ao longo da transição de instrumento. As faixas cinzas são intervalos de confiança de 95%. Linhas/círculos sólidos denotam já ter acessado o ensino superior (ens_sup); linhas/triângulos tracejados denotam matrícula atual (ens_sup_a). Os rótulos no topo marcam o mandato de cada governo. Painel B. O índice de Gini da renda domiciliar per capita, da mesma série oficial do IBGE usada em todo o projeto, validada contra os números publicados pelo próprio IBGE (desvio médio de −0,0001). A linha vertical marca a emenda PNAD Anual/PNAD Contínua de 2015/2016; círculos vazados marcam a PNAD Contínua retroponderada e coletada por telefone de 2020–2021, plotada mas não tratada como comparável ao restante da série.
Como Citar
Se você usar esta figura ou o pipeline que a gera, cite tanto a dissertação quanto esta análise específica. As referências seguem a 7ª edição da APA.
Dissertação (em elaboração; a entrada será atualizada após a defesa):
Mançano, T. (2026). Inequality in access to tertiary education in Brazil: Household incomes, reforming policies, and the politics of who gets in (1990s–2020s) [Dissertação de mestrado não publicada]. Universidade de São Paulo.
Esta figura e o pipeline:
Mançano, T. (2026, 27 de agosto). Desigualdade no acesso e na matrícula no ensino superior (índice de Wagstaff) [Figura e pipeline reprodutível]. Open Data Analysis. https://mancano-tales.github.io/open-data-analysis/pt/posts-pt/wagstaff-acesso-matricula/
No texto: (Mançano, 2026) — ao citar várias análises deste catálogo no mesmo trabalho, a APA as distingue como 2026a, 2026b, … na ordem em que aparecem na lista de referências.
BibTeX:
@mastersthesis{Mancano2026Thesis,
  author = {Man\c{c}ano, Tales},
  title  = {Inequality in Access to Tertiary Education in Brazil: Household
            Incomes, Reforming Policies, and the Politics of Who Gets In
            (1990s--2020s)},
  school = {University of S\~{a}o Paulo},
  year   = {2026},
  type   = {Master's thesis},
  note   = {Unpublished; Graduate Program in Political Science}
}

@misc{Mancano2026_wagstaff_acesso_matricula_pt,
  author       = {Man\c{c}ano, Tales},
  title        = {Desigualdade no acesso e na matr\'{\i}cula no ensino superior (\'{\i}ndice de Wagstaff)},
  year         = {2026},
  month        = aug,
  howpublished = {Open Data Analysis, \url{https://mancano-tales.github.io/open-data-analysis/pt/posts-pt/wagstaff-acesso-matricula/}},
  note         = {Figura e pipeline reprodutível. Código-fonte: \url{https://github.com/mancano-tales/open-data-analysis}, pasta posts-pt/wagstaff-acesso-matricula/. Acesso em AAAA-MM-DD}
}
Uma versão permanente (tag do Git + DOI no Zenodo) será linkada aqui assim que a dissertação for defendida; até lá, cite a URL da página acima e acrescente a data de acesso (código-fonte: https://github.com/mancano-tales/open-data-analysis, pasta posts-pt/wagstaff-acesso-matricula/).
Pipeline
Esta figura usa o painel da Harmonização PNAD / PNAD Contínua, 1992–2025.
Rode estes scripts nesta ordem, a partir da raiz do projeto (cada um grava em data-raw/, de onde o seguinte lê):
shared-pipeline/pnadc/000_PNADC_Download_Consolidate.R— baixa a PNAD Contínua 2012–2025 (1ª entrevista) comPNADcIBGE::get_pnadc()paradata-raw/pnadc_raw/e a consolida emdata-raw/pnadc_consolidado_2012_2025_interview1.rdsshared-pipeline/pnadc/020_PNAD_Anual_Manual_Import_2001_2015.R— baixa os microdados da PNAD Anual 2001–2015 do FTP do IBGE paradata-raw/pnad_anual_raw/e os importa emdata-raw/harmonizing-br-data/output/PNAD_Anual_2001_2015.parquetshared-pipeline/pnadc/050_PNAD_Historica_Manual_Import_1992_1999.R— o mesmo para a PNAD Anual 1992–1999 (PNAD_Anual_1992_1999.parquet)shared-pipeline/pnadc/021_PNAD_Anual_Import_Com_Renda_Zero.R— reimporta a PNAD Anual 2001–2015 mantendo domicílios com renda zero (PNAD_Anual_2001_2015_com_zero.parquet), exigido pelo script 238shared-pipeline/pnadc/035_Splice_Microdados.R— emenda PNAD Anual e PNAD Contínua no painel harmonizado —Microdados_Todas_Idades_1992_2025.parqueteMicrodados_Jovens_18_24_1992_2025.parquetemdata-raw/harmonizing-br-data/output/(carregashared-pipeline/utils/codigos_curso_pnad.R)shared-pipeline/pnadc/238_Serie_Desigualdade_Oficial.R— deriva a série oficial de desigualdade de renda (238_serie_desigualdade_oficial.rds). Entrada opcional:PNADC_Visita5_2019_2022.parquet(microdados da 5ª entrevista da PNAD Contínua, não gerado por nenhum script deste repositório) enxerta os pontos de 2020–2021; sem ele, esses dois anos simplesmente não aparecemplot.R— lêMicrodados_Todas_Idades_1992_2025.parquete238_serie_desigualdade_oficial.rds; grava a figura emoutput/figures/wagstaff-acesso-matricula/— compare com othumbnail.pngdeste post
Todas as etapas upstream acima são Tier A e também são executadas, nesta mesma ordem, por shared-pipeline/build_public_data.R.
Reprodutibilidade
Tier: A
Este pipeline usa apenas dados públicos, acessíveis via pacote/API sem necessidade de credencial (PNADcIBGE, censobr, sidrar, ipeadatar). Rode os scripts em shared-pipeline/ na ordem numérica para reconstruir os dados intermediários.