Harmonização PNAD / PNAD Contínua, 1992–2025
Visão Geral
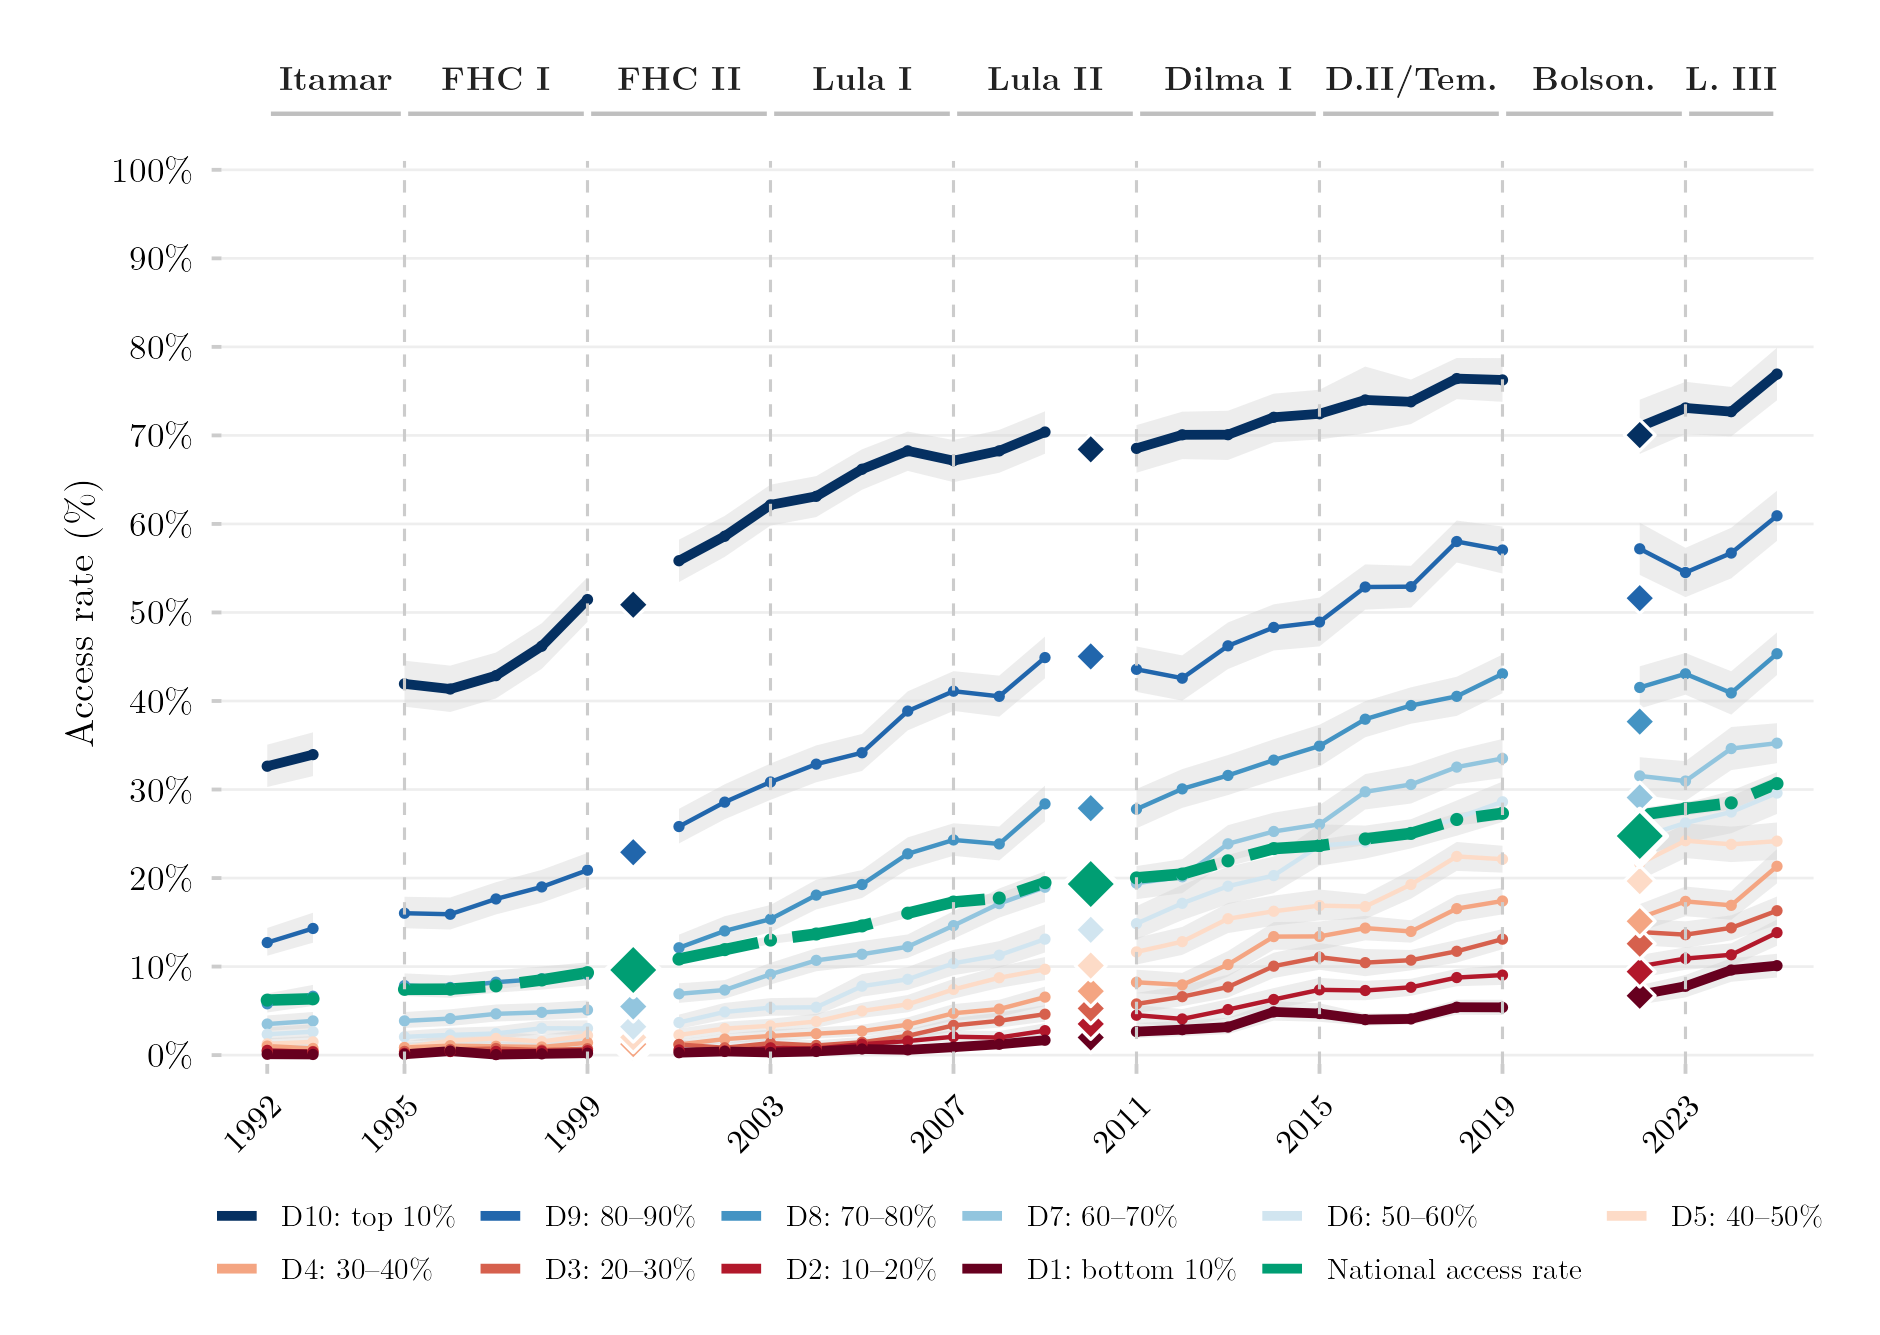
Vinte e uma das figuras deste catálogo não leem de uma única pesquisa domiciliar — elas leem de um painel harmonizado que emenda duas pesquisas diferentes numa série internamente consistente: a PNAD Anual (a principal pesquisa domiciliar anual do Brasil, 1992–2015) e a PNAD Contínua (a pesquisa contínua que a substituiu, 2016–2025). Combiná-las permite que toda figura deste catálogo trate 1992–2025 como um período comparável, em vez de dois fragmentos incompatíveis. Esta página documenta a harmonização em si — as fontes, as decisões, as variáveis resultantes e como o resultado foi validado — não uma figura específica construída em cima dela.
Metodologia
Fontes de dado. A PNAD Anual (1992–2011, coletada pelo IBGE) traz microdados anuais sobre renda, educação e mercado de trabalho; sua região Norte rural foi excluída em 2004–2015 para comparabilidade com a cobertura geográfica inicial da PNAD Contínua. A PNAD Contínua (2012–2025) é a pesquisa contínua redesenhada, com desenho amostral mais complexo (painéis rotativos, amostragem estratificada por unidade primária), exigindo estimação exata de desenho amostral complexo via survey::svydesign(). Os Censos Demográficos decenais (1991, 2000, 2010, 2022), acessados via o pacote R censobr, são usados separadamente como pontos de validação independentes — não fazem parte do painel harmonizado em si.
Decisões metodológicas centrais. Um log numerado de decisões documenta toda escolha consequente feita ao harmonizar as duas pesquisas. As mais importantes:
| Decisão | Descrição |
|---|---|
| D01 | Deflaciona todos os valores monetários a preços de janeiro de 2024 via IPCA (pacote deflateBR) |
| D02 | Exclui observações com renda domiciliar per capita zero |
| D03 | Exclui a região Norte rural (UFs 11–16) da PNAD Anual em 2004–2015, para comparabilidade com a cobertura inicial da PNAD Contínua |
| D11 | Exclui 2020–2021 da série harmonizada (problemas de qualidade de dado da PNAD Contínua na pandemia) |
| D19 | Indicador de matrícula no ensino superior = matriculado atualmente (variável separada de “já ingressou alguma vez”) |
| D20 | Trata o código-sentinela de renda não declarada da PNAD 1992–1999 como ausente na importação, em vez de deixá-lo no topo da distribuição de renda |
| D21 | Mantém a unidade de agregação de renda própria de cada pesquisa através da emenda — família na PNAD Anual, domicílio na PNAD Contínua — em vez de reconstruir as duas numa unidade só |
Bancos e variáveis resultantes. O pipeline produz dois arquivos prontos para análise: o subconjunto de 18–24 anos usado nas figuras de acesso ao ensino superior, e a população total com renda válida, usada na construção dos decis de renda. Ambos são restritos a indivíduos com renda domiciliar per capita estritamente positiva; a PNAD Contínua é restrita aos respondentes da primeira entrevista para evitar que sua estrutura de painel infle o tamanho da amostra. A série cobre 1992–1999, 2001–2009, 2011–2019 e 2022–2025 — 2000 e 2010 estão ausentes porque não houve PNAD em anos de Censo. As variáveis centrais incluem renda (nominal e corrigida pela inflação), um indicador de acesso ao ensino superior validado contra uma série de referência externa com precisão de ±0,3 pontos percentuais no nível nacional, decil e vintil de renda (calculados dentro de cada ano e fonte, usando pesos amostrais), e uma flag de fonte (2012–2015 existe nas duas pesquisas, uma sobreposição intencional mantida para validar a emenda — qualquer análise que atravesse esses anos precisa escolher uma única fonte para não contar em dobro).
Validação externa. A série harmonizada de acesso ao ensino superior foi comparada contra a série independente de Salata et al. (2025), que usa um pipeline de processamento de dado inteiramente diferente. Depois de corrigir dois erros de codificação — a construção original omitia respondentes que já haviam concluído ou abandonado o ensino superior, concentrado no decil de renda mais alto; e, achado numa auditoria de código em 2026-09-15, os dicionários da PNAD de 2001–2006 codificam o pré-vestibular sob o número que os dicionários dos anos 1990 usam para mestrado/doutorado, de modo que por seis anos vestibulandos foram contados como ingressantes no superior (cerca de +1,5 ponto percentual no nacional, até +4,8 no decil mais alto) — as duas séries concordam de perto em toda a janela:
| Período | Fonte | Diferença vs. referência | Avaliação |
|---|---|---|---|
| 1992–1999 | PNAD histórica | −0,08 a +0,09 pp | Alinhado |
| 2001–2003 | PNAD Anual | −0,16 a −0,04 pp | Alinhado |
| 2004–2006 | PNAD Anual | +0,16 a +0,24 pp | Alinhado — exclusão do Norte rural |
| 2007–2015 | PNAD Anual | +0,09 a +0,33 pp | Alinhado |
| 2016–2019 | PNAD Contínua | −0,01 a −0,08 pp | Alinhado |
| 2022 | PNAD Contínua | −0,71 pp | Aceitável — Norte rural mantido |
Nenhuma quebra artificial foi detectada no ponto de emenda PNAD/PNAD Contínua (2012–2015), onde as duas fontes acompanham a série de referência de forma independente, com diferença de até 0,4 pontos percentuais entre si.
Como Citar
Se você usar este painel harmonizado ou o pipeline que o gera, cite tanto a dissertação quanto esta análise específica. As referências seguem a 7ª edição da APA.
Dissertação (em elaboração; a entrada será atualizada após a defesa):
Mançano, T. (2026). Inequality in access to tertiary education in Brazil: Household incomes, reforming policies, and the politics of who gets in (1990s–2020s) [Dissertação de mestrado não publicada]. Universidade de São Paulo.
Este painel harmonizado e o pipeline:
Mançano, T. (2026, 10 de setembro). Harmonização PNAD / PNAD Contínua, 1992–2025 [Base harmonizada e pipeline reprodutível]. Open Data Analysis. https://mancano-tales.github.io/open-data-analysis/pt/posts-pt/harmonizacao-pnad-pnadc/
No texto: (Mançano, 2026) — ao citar várias análises deste catálogo no mesmo trabalho, a APA as distingue como 2026a, 2026b, … na ordem em que aparecem na lista de referências.
BibTeX:
@mastersthesis{Mancano2026Thesis,
  author = {Man\c{c}ano, Tales},
  title  = {Inequality in Access to Tertiary Education in Brazil: Household
            Incomes, Reforming Policies, and the Politics of Who Gets In
            (1990s--2020s)},
  school = {University of S\~{a}o Paulo},
  year   = {2026},
  type   = {Master's thesis},
  note   = {Unpublished; Graduate Program in Political Science}
}

@misc{Mancano2026_harmonizacao_pnad_pnadc_pt,
  author       = {Man\c{c}ano, Tales},
  title        = {Harmoniza\c{c}\~{a}o PNAD / PNAD Cont\'{\i}nua, 1992--2025},
  year         = {2026},
  month        = sep,
  howpublished = {Open Data Analysis, \url{https://mancano-tales.github.io/open-data-analysis/pt/posts-pt/harmonizacao-pnad-pnadc/}},
  note         = {Base harmonizada e pipeline reprodutível. Código-fonte: \url{https://github.com/mancano-tales/open-data-analysis}, pasta posts-pt/harmonizacao-pnad-pnadc/. Acesso em AAAA-MM-DD}
}
Uma versão permanente (tag do Git + DOI no Zenodo) será linkada aqui assim que a dissertação for defendida; até lá, cite a URL da página acima e acrescente a data de acesso (código-fonte: https://github.com/mancano-tales/open-data-analysis, pasta posts-pt/harmonizacao-pnad-pnadc/).
Pipeline
Scripts desta harmonização, em ordem de execução:
shared-pipeline/pnadc/000_PNADC_Download_Consolidate.R— baixa e consolida a PNAD Contínua, 2012–2025shared-pipeline/pnadc/020_PNAD_Anual_Manual_Import_2001_2015.R— importa a PNAD Anual 2001–2015 a partir dos microdados brutos em formato SASshared-pipeline/pnadc/050_PNAD_Historica_Manual_Import_1992_1999.R— importa a PNAD Anual 1992–1999shared-pipeline/pnadc/021_PNAD_Anual_Import_Com_Renda_Zero.R— importação alternativa da PNAD Anual, usada por um subconjunto de figurasshared-pipeline/pnadc/035_Splice_Microdados.R— emenda tudo acima nos dois bancos analíticos harmonizadosshared-pipeline/utils/codigos_curso_pnad.R— códigos de curso da PNAD Anual por regime de dicionário (1992–99 / 2001–06 / 2007+), carregado pelo 035 e pelos posts por rede de ensinoshared-pipeline/pnadc/238_Serie_Desigualdade_Oficial.R— deriva a série oficial de desigualdade de renda (Gini, Palma) a partir do painel harmonizadoshared-pipeline/censo/040_Censo_Pontos_Validacao.R— pontos de validação independentes via Censo Demográfico (não fazem parte do painel em si)
Ou rode shared-pipeline/build_public_data.R, que executa esses scripts na ordem certa automaticamente.
Figuras deste catálogo construídas sobre esta harmonização: todo post com a tag “PNAD/PNADC” linka de volta pra esta página na sua própria seção de Pipeline.
Reprodutibilidade
Tier: A
Este pipeline usa apenas dados públicos, acessíveis via pacote/API sem necessidade de credencial (PNADcIBGE, censobr). Rode os scripts acima — ou shared-pipeline/build_public_data.R — em ordem para reconstruir o painel harmonizado do zero.